The main goal of
llama.cppis to enable LLM (and VLM) inference with minimal setup and state-of-the-art performance on a wide range of hardware … 项目 README
llama.cpp 是端侧大模型推理领域常用的开源引擎,在最近终于 release v1.0.0 版本,在此契机笔者想要以较为全面的视角,宏观端侧推理引擎的核心设计与实现,整理学习本项目的同时,也能带给后续读者一定的启发。
本系列关注其设计思想与架构实现:引擎如何描述不同模型架构的计算过程,又如何在不同硬件平台上高效执行这些计算。笔者将结合源码调试与对照实验,分析其中的关键设计及其对推理性能的影响。
本系列共七篇,围绕模型加载、计算图构建、执行调度与内存管理展开。实验选用消费级硬件可运行的 Qwen3-4B,在 CUDA 和 Metal 后端上进行。模型算法与后端算子的讨论限于理解引擎设计和解释实验结果所需的范围。
第一篇总览推理流程。笔者以 llama-simple 为入口,梳理单次前向计算与自回归生成循环之间的关系,定位各阶段的关键函数,并以时间、空间和质量作为分析引擎设计的三个维度。本文在 Jetson 与 Mac 上使用相同的模型和输入,测量分阶段耗时与内存占用,为后续各篇提供实验基线。

虚线表示篇章之间的总分关系,实线表示主要执行阶段及其数据依赖。一次前向完成后,历史 K/V 作为缓存状态保留,采样得到的 token ID 作为下一轮的输入。
推理的计算与硬件基础
矩阵运算与前向计算图
矩阵乘法是 Transformer 前向传播的核心运算之一。以自注意力层为例,设输入矩阵 X 的每一行对应一个 token 位置。查询 Q、键 K 和值 V 由同一份输入分别乘以三组可学习的权重得到。
Q = XWQ, K = XWK, V = XWV
以第一个式子为例,X 的一行与查询权重的一列做点积,就得到该位置的一个查询分量。不同的行、列组合可以独立求值,因此能并行计算多个输出元素。
对当前位置,Q 与各可见位置的 K 计算匹配分数。分数归一化为注意力权重,再按权重汇总相应位置的 V,形成当前位置的注意力输出。

沿图中的箭头看,计算注意力权重需要 Q 和 K 就绪,加权汇总还需要 V。把一轮前向中的运算按这样的数据依赖连接起来,便得到有向无环图(DAG)。图上的依赖限定哪些运算必须先完成,每个矩阵运算内部仍可并行计算大量输出元素。
Qwen3 的前馈网络(FFN)同样可以用计算图描述。up 和 gate 投影读取同一份输入,门控分支经过激活后与 up 分支逐元素相乘,再由 down 投影得到输出。
端侧硬件的核心约束
CPU 负责控制流程和任务提交,GPU 可以并行计算矩阵乘法中的大量输出元素。
GPU 的片上存储容量有限。Mac 和 Jetson 都使用 CPU 与 GPU 共享的系统内存来容纳模型权重和 KV 缓存。执行前向计算时,从内存读取权重的带宽会影响计算单元获得数据的速度。
以一层投影为例,可以分别观察算力、内存带宽和容量的约束。
| 条件 | 在一次推理中的表现 |
|---|---|
| 算力 | 处理整段提示词(prefill)时,多个位置的投影可以并行计算,运算单元有更多工作可做。 |
| 内存带宽 | 单请求逐 token 生成(decode)时,一步通常只新增一行输入,却仍要访问各层权重。数据供给速度可能限制生成速度。 |
| 可用内存容量 | 权重常驻期间,还要容纳历史 K/V 和计算工作区。留给 KV 的空间会限制可保留的上下文长度。 |
核心框架与影响因素
评价维度:时间、空间和质量
算力和带宽影响前向计算耗时。权重、KV 缓存与中间结果共同决定内存需求。改变权重或 KV 缓存的数值精度,还可能改变模型输出。
时间主要分为得到首个 token 的等待 TTFT 和每个后续输出 token 的平均耗时 TPOT。空间要区分随模型存在的权重、跨轮保留的 KV,以及一次执行所需的中间占用内存。质量则要回到预测本身:给定同一前缀,模型给真实下一词的概率或任务答案是否发生变化?
设计选择:放置、调度和表示
固定模型后,可以从放置、调度和表示三个方面分析引擎设计,观察每项选择如何影响时间、空间和质量。
| 设计选择 | 如何影响三要素 |
|---|---|
| 放置 · 数据放在哪里 | 哪些层的权重放在 GPU 侧,哪些留在 CPU 侧,会影响两端的内存占用和跨后端传输。 |
| 调度 · 计算怎样安排 | 中间结果用完后,后续算子是否可以复用这块缓冲区,降低峰值内存占用。 |
| 表示 · 数值怎样保存 | 量化权重或 KV 缓存可以减少存储和读取的数据量,也可能影响输出质量。 |
前两类实验固定计算语义,以相同前缀的输出作校验。涉及有损表示时,质量也成为要测量的代价。第六篇会用同一份语料比较两种量化的表示。
从 simple 看一次推理过程
项目结构与分层设计
llama.cpp 在 v1.0.0 的官方公告中,强调并重申了其分层设计的理念,不同层级的职责划分,接口稳定抽象最终能够长期支持多种后端,多种模型架构。模型适配与硬件适配分在两层。推理库 libllama 描述每种模型需要哪些权重、如何用这些权重构建计算图;张量库 libggml 提供图中的算子,并通过统一的后端接口调度执行。
以 Qwen3 为例,libllama 指定输入与查询权重相乘。相同的投影在 Mac 上由 Metal 后端执行,在 Jetson 上由 CUDA 后端执行,两端共用同一份模型建图代码。Qwen3 建图源码 · ggml 后端接口
一次前向与生成循环
以 llama-simple 为例,从加载模型到生成文本,一次请求依次经过以下阶段。

加载模型文件 llama_model:第二篇将说明 GGUF 文件结构设计,模型加载模式(以 mmap 为例),硬件选择规划逻辑等,最终得到 llama_model 对象完整持有模型元数据、权重数据等。
创建 llama_context:这里主要阐述推理上下文初始化时的核心工作,除了创建必要的后端准备,KV Cache 内存初始化,核心围绕 sched_reserve 第一次图构建与规划,了解掌握 DAG 图如何从数学模型到逻辑计算图 cgraph,以及逻辑计算图 cgraph 如何结合实际后端环境进行图切割规划。
第三篇讨论如何从模型构建逻辑计算图,第四篇讨论如何按后端切分计算图并规划内存复用。
Prefill:第一次处理 prompt batch 时对于图构建与规划类似 context 的工作,会进行尝试图复用。因此在第 5 篇主要着重于实际计算的执行,异步调度等机制,与后端接口的设计交互,并初步展开 cuda 和 metal 后端的实现。
采样:根据本轮前向得到的 logits 选择下一个 token。第七篇讨论采样策略与生成循环。
Decode:将刚采样的 token 作为下一轮输入,沿用此前保留的 K/V,计算新的 logits。第六篇讨论 KV 缓存的写入与复用。
实践:耗时与内存分析
实验环境
两端使用同一份 Qwen3-4B Q4_K_M 权重和同一版本的 llama-simple(v1.0.0,b1b770d90,Release)。37/37 层均放在 GPU 上。提示词分为 4 个 token,经 1 次 prefill 和 15 次 decode,贪心采样共输出 16 个 token。
| 环境 | Mac mini | Jetson Orin Nano Super |
|---|---|---|
| 硬件与系统 | M6,24 GiB,macOS 27.2.1 | Orin,8 GB,Ubuntu 22.04.5,L4T 36.4.3,MAXN_SUPER |
后端与加载方式(auto) |
Metal,mmap,模型位于外置 SSD |
CUDA 12.6,none |
| 采集工具 | Instruments · Metal System Trace | Nsight Systems 2024.5.4 |
1 | ./build/bin/llama-simple -m "$STUDY_MODEL" -ngl 99 -n 16 'Hello my name is' |
推理耗时的分布
先看首个 token。两端各连续启动两个新进程,保留系统页缓存,分别测量模型加载、上下文创建及从进入 main 到首个 token 输出的耗时。
| 运行 | 加载模型 | 创建上下文 | 到首个输出 |
|---|---|---|---|
| Mac 第一次 | 2.75 s | 14 ms | 7.63 s |
| Mac 第二次 | 0.15 s | 13 ms | 0.25 s |
| Jetson 第一次 | 7.98 s | 69 ms | 8.39 s |
| Jetson 第二次 | 6.07 s | 51 ms | 6.38 s |
Mac 首次启动时,Metal 算子库准备用了 4.78 s,第二次仅需 14 ms。Jetson 两次都以模型加载为主。Metal 可直接使用映射的文件页,Jetson 的 CUDA 后端即使命中页缓存,仍需将权重复制到设备缓冲区。第二篇将展开两端的加载策略。
再看模型就绪后的生成过程。下表取自两端各一次普通运行的引擎计时,GPU 时间线按相同参数另行采集。
| 阶段 | Mac | Jetson |
|---|---|---|
| Prefill(4 个输入 token) | 42.28 ms | 236.10 ms |
| Decode(15 步合计) | 312.65 ms | 1030.78 ms |
| Decode(平均每步) | 20.84 ms | 68.72 ms |
| 采样(16 次合计) | 0.88 ms | 5.11 ms |
本例中,15 步 decode 占前向总耗时(prefill + decode)的 88.1%(Mac)和 81.4%(Jetson)。
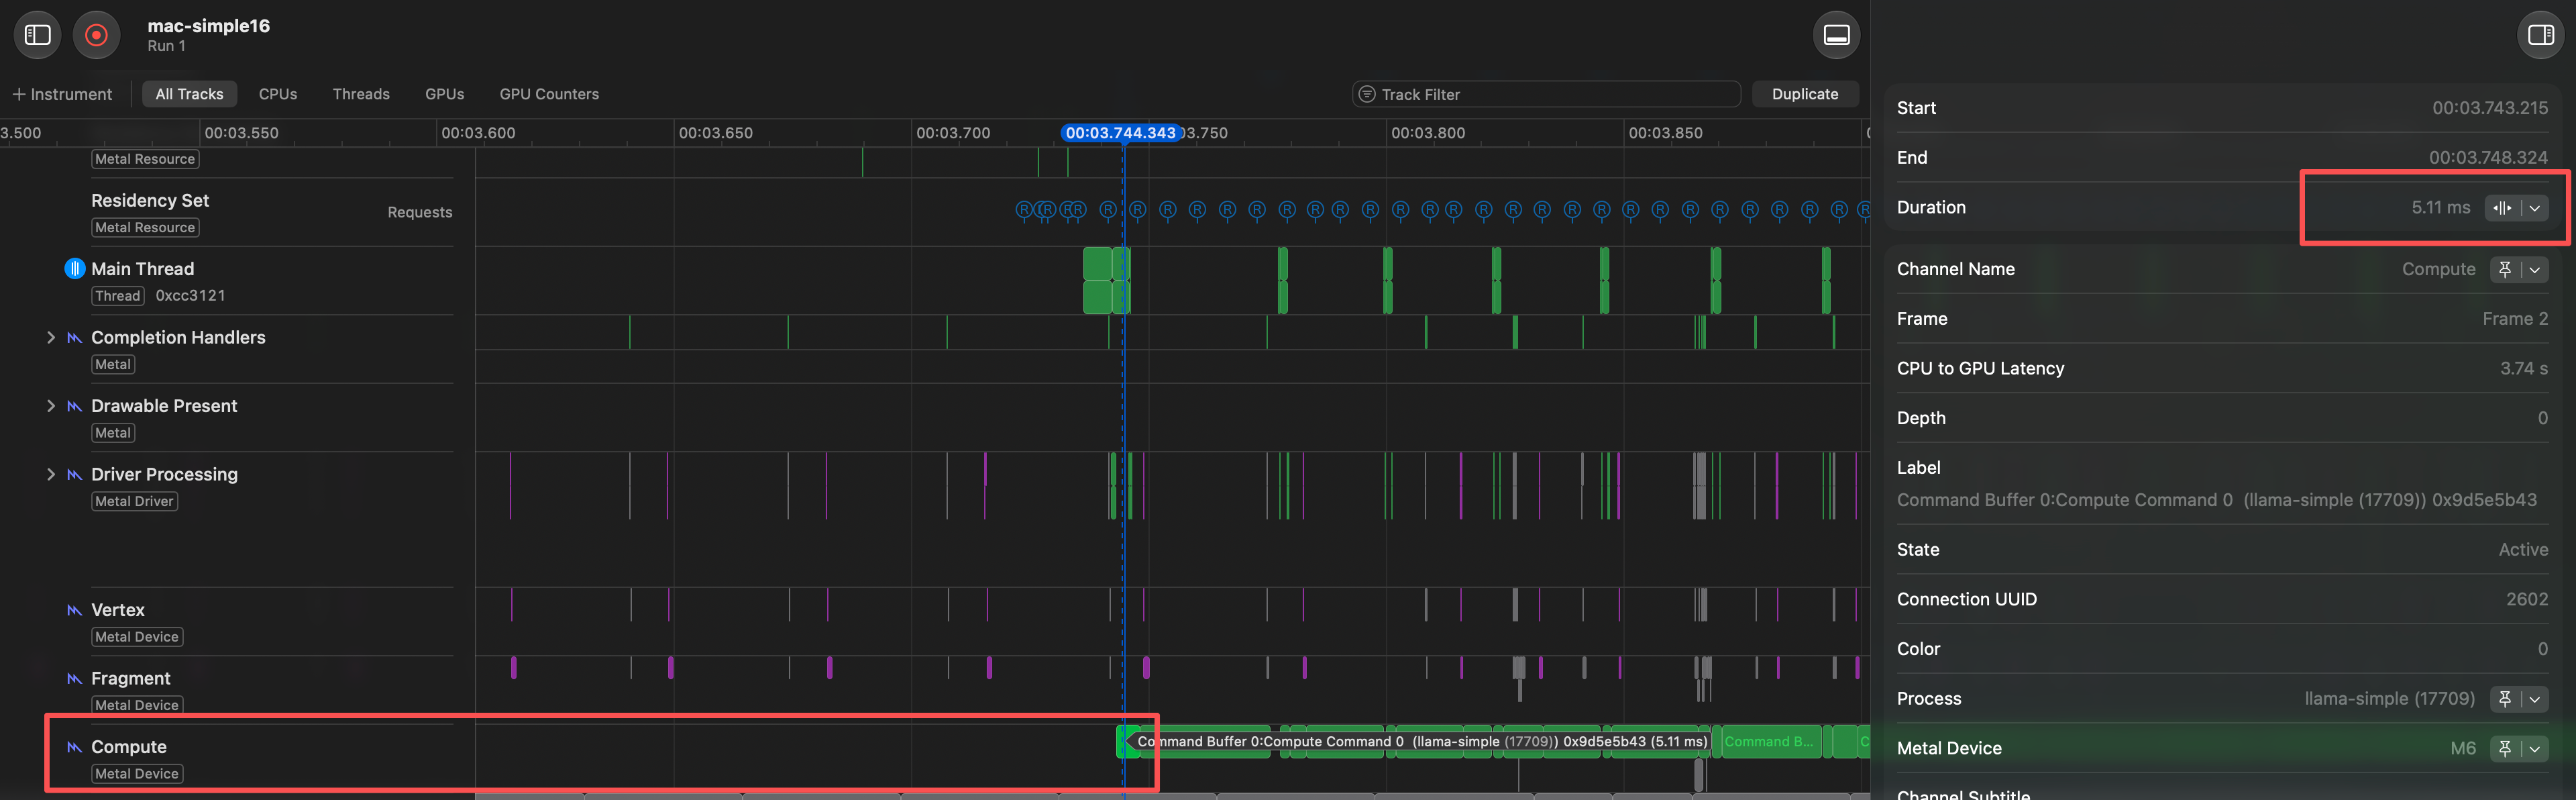
图 1 Mac 上的 Metal 前向计算时间线
选中的 Compute 命令耗时 5.11 ms。按执行顺序推定,prefill 对应前两条 Compute 命令,累计 32.42 ms。
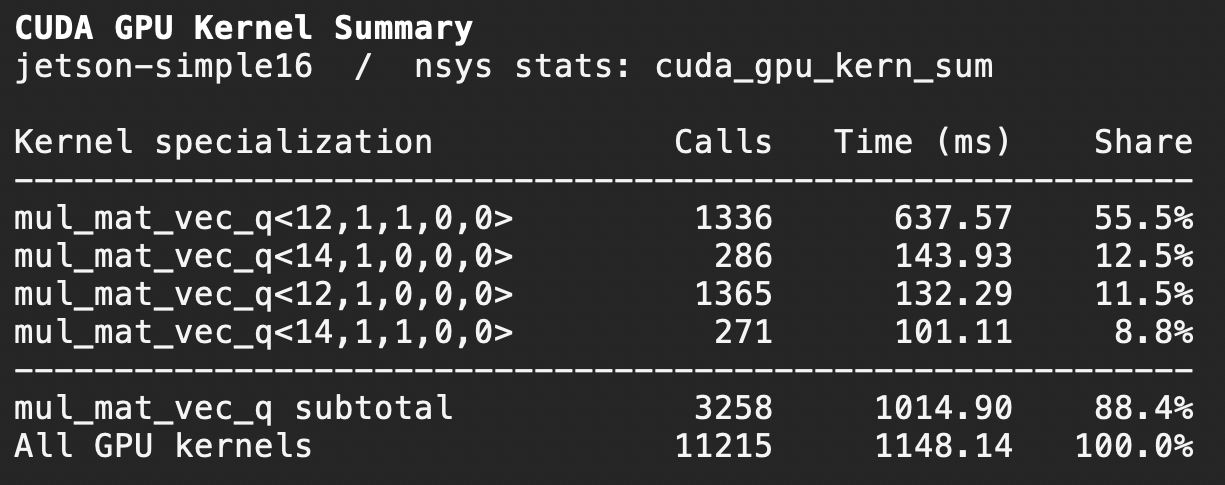
图 2 Jetson 上的 CUDA 内核耗时分布
四种 mul_mat_vec_q 内核合计占本次采集全部 GPU 内核累计执行时间的 88.4%。
内存的创建与占用
加载模型时先建立权重缓冲区。创建 llama_context 时再分配 KV 缓存,并由 sched_reserve 为计算图预留工作区。下表为引擎报告的缓冲区容量,单位为 MiB。
| 用途 | Mac | Jetson |
|---|---|---|
| 权重(设备侧 / 主机侧) | 2375.91 / 304.28 | 2375.91 / 304.28 |
| KV 缓存(设备侧) | 36.00 | 36.00 |
| 计算工作区(设备侧 / 主机侧) | 5.38 / 0.16 | 2.48 / 0.16 |
| 输出缓冲区(主机侧) | 0.58 | 0.58 |
本例只预留了 256 个上下文位置,设备侧权重约为 KV 缓存的 66 倍。Jetson 的进程峰值 RSS 为 548.82 MiB,这个指标未覆盖全部 CUDA 分配。
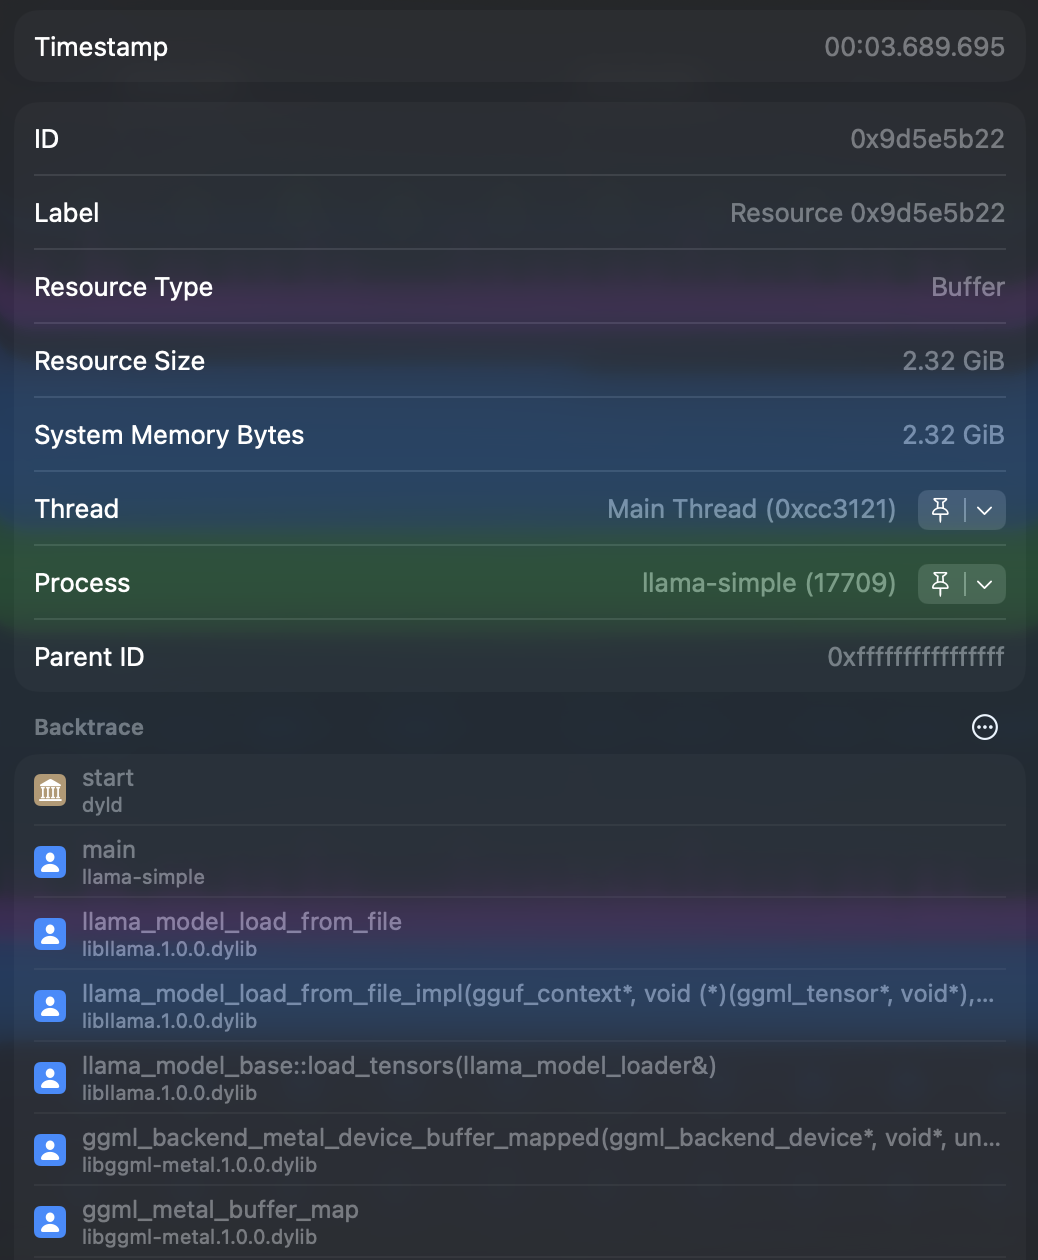
图 3 Mac 上的模型权重映射
3.690 s 处创建的 Metal 缓冲区大小为 2.32 GiB。调用栈显示,load_tensors 经由 ggml_metal_buffer_map 映射权重。
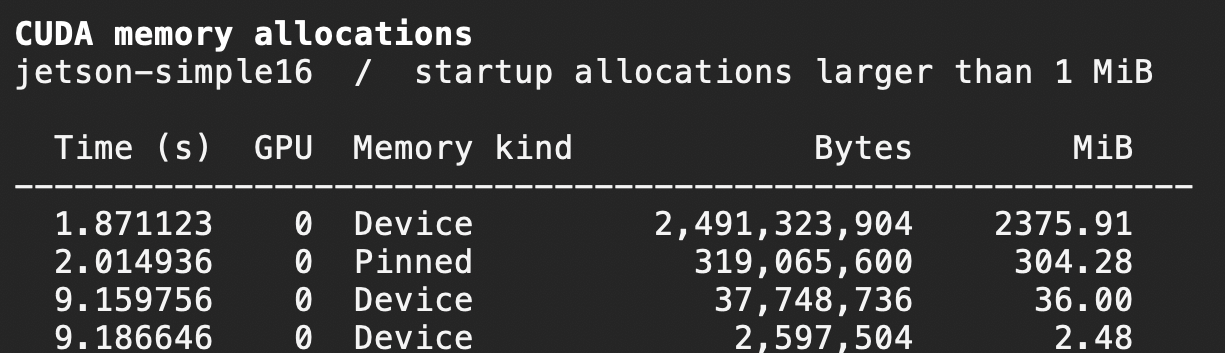
图 4 Jetson 上的 CUDA 内存分配时序
设备权重(2375.91 MiB)分配于 1.871 s,KV 缓存(36 MiB)分配于 9.160 s,随后分配计算工作区。
总结
在本篇文章中我们了解了端侧推理的基本原理和硬性限制,建立了「时间、空间、质量」三要素的评估纬度,在后续文章中将会通过尝试改变「放置、调度、表示」三方面设计去剖析整个项目。以及本篇以 simple 为例子大致展开了一次前向推理的核心流程,并通过在 Mac 和 Jetson 上进行性能实验,重点关注到耗时和内存分布与占比。
在第二章中我们将继续推进到模型文件与加载,深入 GGUF 文件的设计,与各种加载模式的设计剖析,最终得到内存结构体 llama_model。